Veri bilimi tezinizde bir makine öğrenmesi modeli eğitecek, bir istatistiksel analiz yapacak veya bir görselleştirme projesi geliştirecekseniz, en çok zaman kaybettiren adımlardan biri doğru veri setini bulmaktır. Bu yazı, veri bilimi tezlerinde en sık başvurulan üç açık veri kaynağı türünü — ulusal istatistik/açık veri portalları, veri bilimi platformları ve akademik veri kümesi arşivleri — hangi durumda hangisini seçeceğinizle birlikte anlatıyor. Veri bilimi tezleri diğer sosyal bilim tezlerinden farklı bir zorlukla karşılaşır: araştırma sorunuz genellikle bir yöntem veya modelleme yaklaşımı etrafında kurulur, ama o yöntemi gösterebilmeniz için önce üzerinde çalışacağınız, kalitesi ve kapsamı belli bir veri setine ihtiyacınız vardır. Yanlış veri seti seçimi, tezinizin ortasında yöntem değiştirmenize ya da haftalarca veri temizliğiyle uğraşmanıza yol açabilir — bu yüzden veri seti kararı, araştırma sorunuzla eş zamanlı, danışmanınızla birlikte alınması gereken bir karardır.
TÜİK ve kamu açık veri portalları: resmî ve güvenilir, ama ham değil
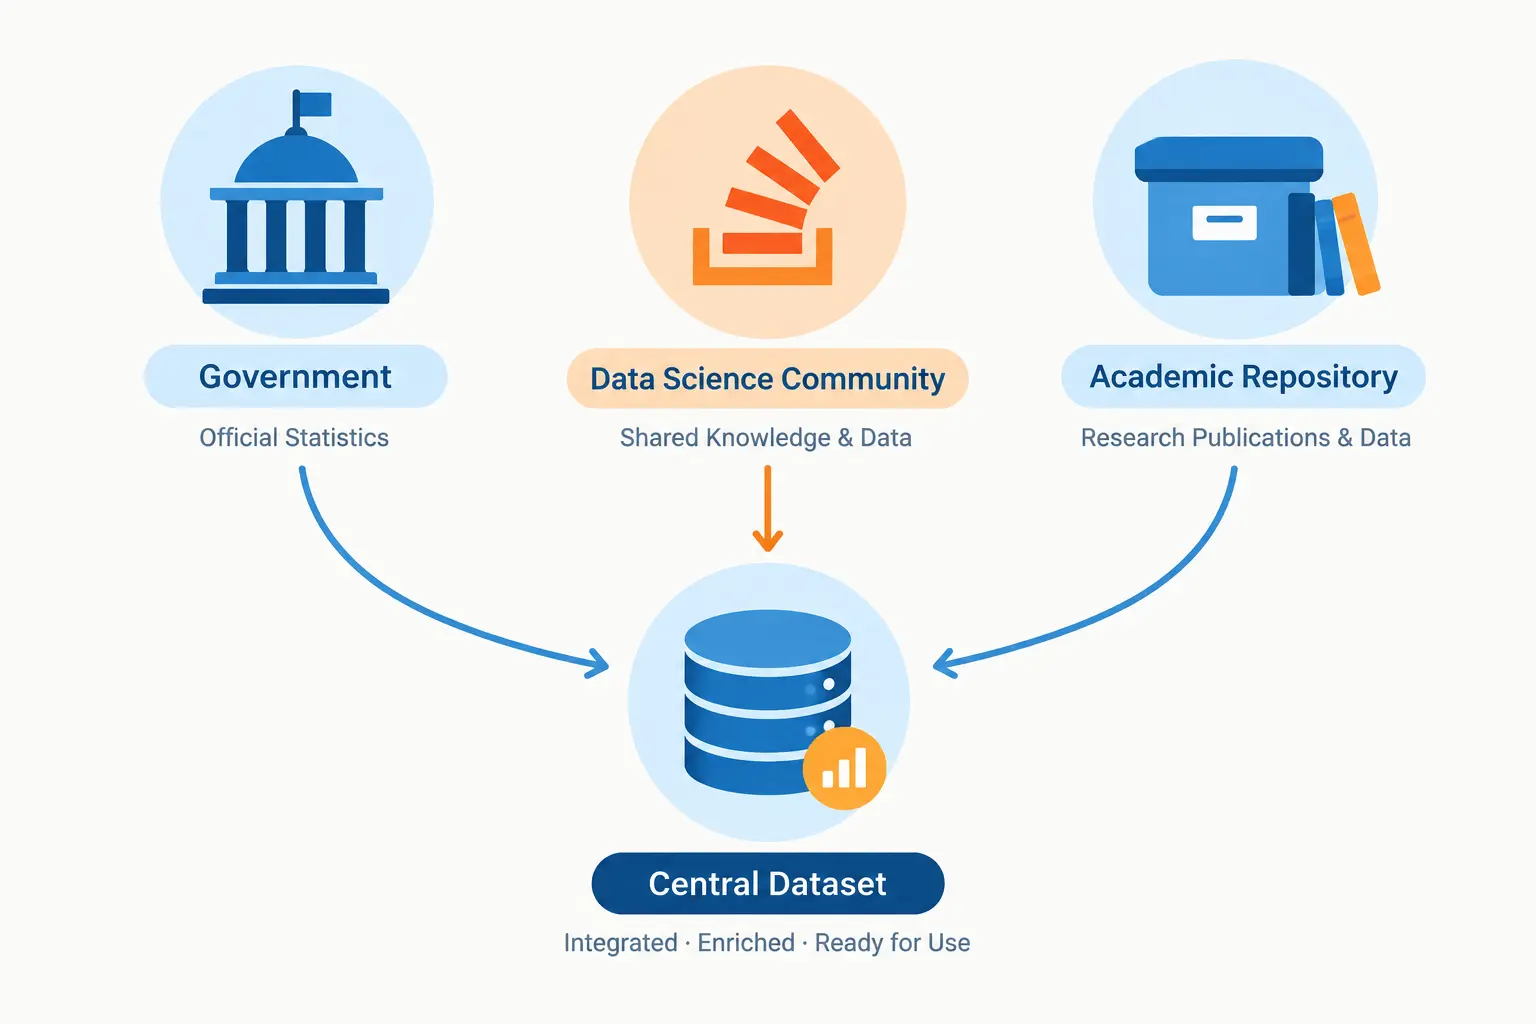
Türkiye İstatistik Kurumu (TÜİK), demografi, ekonomi, tarım, sağlık ve eğitim gibi alanlarda toplulaştırılmış resmî istatistikler yayımlar. Kamu kurumlarının açık veri setleri için ulusal portal data.gov.tr adresindedir; buna ek olarak büyükşehir belediyeleri de kendi portallarını işletir — örneğin İBB Açık Veri Portalı (data.ibb.gov.tr) ve İzmir Büyükşehir Belediyesi Açık Veri Portalı (acikveri.bizizmir.com), ulaşım, altyapı ve kent hizmetleriyle ilgili veri setlerini indirilebilir biçimde sunar. Bu kaynakların avantajı güvenilirlik ve resmiyettir — tezinizde kullandığınız verinin kaynağını sorgusuz kabul ettirir. Dezavantajı ise, TÜİK verilerinin çoğunlukla toplulaştırılmış (aggregate) tablolar hâlinde sunulması: bireysel gözlem düzeyinde (satır satır) ham veri arıyorsanız, bu kaynaklar her zaman yeterli olmayabilir; bu durumda makine öğrenmesi projeniz için belediye portallarındaki kayıt düzeyindeki veri setlerine ya da Kaggle veya UCI gibi platformlara yönelmeniz gerekebilir.
Bu resmî kaynakları birbirinden ayırmak da önemlidir: TÜİK doğrudan kendi ürettiği istatistikleri yayımlarken, açık veri portalları farklı birimlerin (belediye daireleri, iştirakler, kamu kurumları) yayımladığı veri setlerini bir araya getiren bir katalog işlevi görür. Portalda bulduğunuz bir veri setinin asıl üreticisini (hangi kurum veya birim) tespit edip kaynakçanızda o kurumu esas almanız, yalnızca portal adını veren genel bir atıftan daha doğru bir uygulamadır.
Kaggle: makine öğrenmesi projeleri için hazır, etiketli veri setleri
Kaggle, kullanıcıların yüklediği binlerce veri setini ve bu veri setleri üzerine yazılmış örnek kod defterlerini (notebook) barındıran bir platformdur. Veri bilimi tezinizde bir sınıflandırma, regresyon veya kümeleme modeli eğitecekseniz, Kaggle genellikle en hızlı başlangıç noktasıdır — pek çok veri seti zaten temizlenmiş, etiketlenmiş ve model eğitimine hazır hâldedir. Ancak bu kolaylığın bir bedeli var: Kaggle’daki veri setleri kullanıcılar tarafından yüklendiği için, verinin kaynağını, toplanma yöntemini ve güncelliğini kendiniz doğrulamanız gerekir. Tezinizde bir Kaggle veri seti kullanıyorsanız, veri setinin sayfasında belirtilen orijinal kaynağı (genellikle bir kurum, araştırma projesi veya API) bulup mümkünse o birincil kaynağı da kaynakçanıza ekleyin — yalnızca “Kaggle’dan alındı” demek, veri sağlayıcısını gizler ve akademik şeffaflık açısından yetersiz kalır.
UCI Machine Learning Repository ve akademik veri kümesi arşivleri
UCI Machine Learning Repository, 1987’de Kaliforniya Üniversitesi Irvine’da (UCI) bir FTP arşivi olarak kurulan ve o günden beri makine öğrenmesi araştırmalarında kullanılan, kütüphaneciler tarafından sürdürülen bir veri seti arşividir. Kaggle’a göre daha az veri seti barındırır, ama her veri setinin kökeni ve toplanma yöntemi genellikle daha ayrıntılı belgelenmiştir — bu da onu akademik bir tez için bazen daha güvenilir bir tercih yapar. Alanınıza özgü başka akademik arşivler de olabilir (örneğin doğal dil işleme için dil kaynak kümeleri, görüntü işleme için standart benchmark veri setleri); danışmanınızla alanınızın standart referans veri setlerinin hangileri olduğunu konuşun — bilinen bir benchmark veri seti üzerinde çalışmak, sonuçlarınızı literatürdeki diğer çalışmalarla karşılaştırılabilir kılar.
Benchmark bir veri seti kullanmanın asıl avantajı karşılaştırılabilirliktir: tezinizde geliştirdiğiniz modelin başarımını (doğruluk, F1 skoru gibi metriklerle), aynı veri setinde daha önce yayımlanmış çalışmaların sonuçlarıyla doğrudan karşılaştırabilirsiniz. Kendi topladığınız veya az bilinen bir veri setinde bu karşılaştırma mümkün olmaz — modeliniz iyi performans gösterse bile, bunun modelin kendisinden mi yoksa veri setinin kolaylığından mı kaynaklandığını ayırt etmek zorlaşır.
Üç kaynak türü arasında nasıl karar verirsiniz?
Karar, tezinizin araştırma sorusuna bağlıdır:
- Türkiye’ye özgü bir toplumsal/ekonomik eğilimi analiz ediyorsanız (örneğin bölgesel işsizlik eğilimleri, tarımsal üretim verileri) — TÜİK’ten ya da ilgili kamu/belediye açık veri portalından başlayın.
- Bir makine öğrenmesi modelini eğitip test etmek istiyorsanız ve konu Türkiye’ye özgü olmak zorunda değilse — Kaggle’da hazır, etiketli bir veri seti aramak zaman kazandırır.
- Bulgularınızı literatürdeki diğer çalışmalarla karşılaştırmak istiyorsanız — alanınızın standart benchmark veri setini (UCI veya alan-özel bir arşiv) kullanın.
- Kendi veri setinizi toplamak zorundaysanız (örneğin bir API’den web kazıma yoluyla) — bu durumda verinin toplanma tarihini, yöntemini ve kapsamını tezinizde ayrıntılı belgeleyin; bu, tekrarlanabilirlik açısından jüri önünde sıkça sorulan bir konudur.
Bu dört madde birbirini dışlamaz — pek çok veri bilimi tezi bunlardan birkaçını bir arada kullanır: örneğin araştırma sorusu Türkiye bağlamlı bir modelleme problemiyse, TÜİK’ten temel göstergeleri, Kaggle’dan ise modelleme için genişletilmiş bir veri setini birlikte kullanabilirsiniz. Önemli olan, her kaynağın tezinizde hangi işlevi gördüğünü (bağlamsallaştırma mı, model eğitimi mi, karşılaştırma mı) yöntem bölümünde net biçimde ayırt etmenizdir.
Kendi veri setinizi toplarsanız: web kazıma ve API’ler
Bazı veri bilimi tezleri, hazır bir veri seti yerine kendi verinizi (web kazıma yoluyla veya bir API üzerinden) toplamanızı gerektirir — örneğin bir sosyal medya platformundan kamuya açık gönderileri toplamak veya bir e-ticaret sitesinden fiyat verisi kazımak. Bu yaklaşımın avantajı özgünlüktür: kimsenin daha önce kullanmadığı bir veri setiyle çalışırsınız. Dezavantajı ise sorumluluğun tamamen size ait olmasıdır — verinin toplanma yönteminin ilgili platformun kullanım şartlarına uygun olduğunu, kişisel veri içermediğini (veya içeriyorsa KVKK/GDPR gibi düzenlemelere uygun anonimleştirildiğini) ve toplama sürecinin tekrarlanabilir biçimde belgelendiğini göstermeniz gerekir. Danışmanınızla web kazıma yapmadan önce bu üç noktayı (kullanım şartları, kişisel veri, belgeleme) mutlaka konuşun; kişisel veri barındıran bir kaynakla çalışıyorsanız etik kurul sürecinizi de buna göre planlayın, ayrıntılar için tez için etik kurul izni nasıl alınır yazımıza bakabilirsiniz.
Sentetik veri bir alternatif olabilir mi?
Gerçek veriye erişim kısıtlıysa veya kişisel veri riski taşıyorsa, bazı veri bilimi tezleri sentetik (yapay olarak üretilmiş) veri kullanmayı tercih eder. Sentetik veri, gerçek verinin istatistiksel özelliklerini taklit eden ama gerçek bireylere ait olmayan yapay gözlemlerden oluşur. Bu yaklaşımın tez için avantajı gizlilik riskinin ortadan kalkmasıdır; dezavantajı ise modelinizin gerçek dünya verisindeki inceliği yakalayıp yakalamadığının belirsiz kalmasıdır. Sentetik veri kullanıyorsanız, bunu tezinizde açıkça belirtin ve mümkünse bulgularınızı küçük bir gerçek veri örneklemiyle de doğrulayın.
Veri setini seçtikten sonra kontrol etmeniz gerekenler
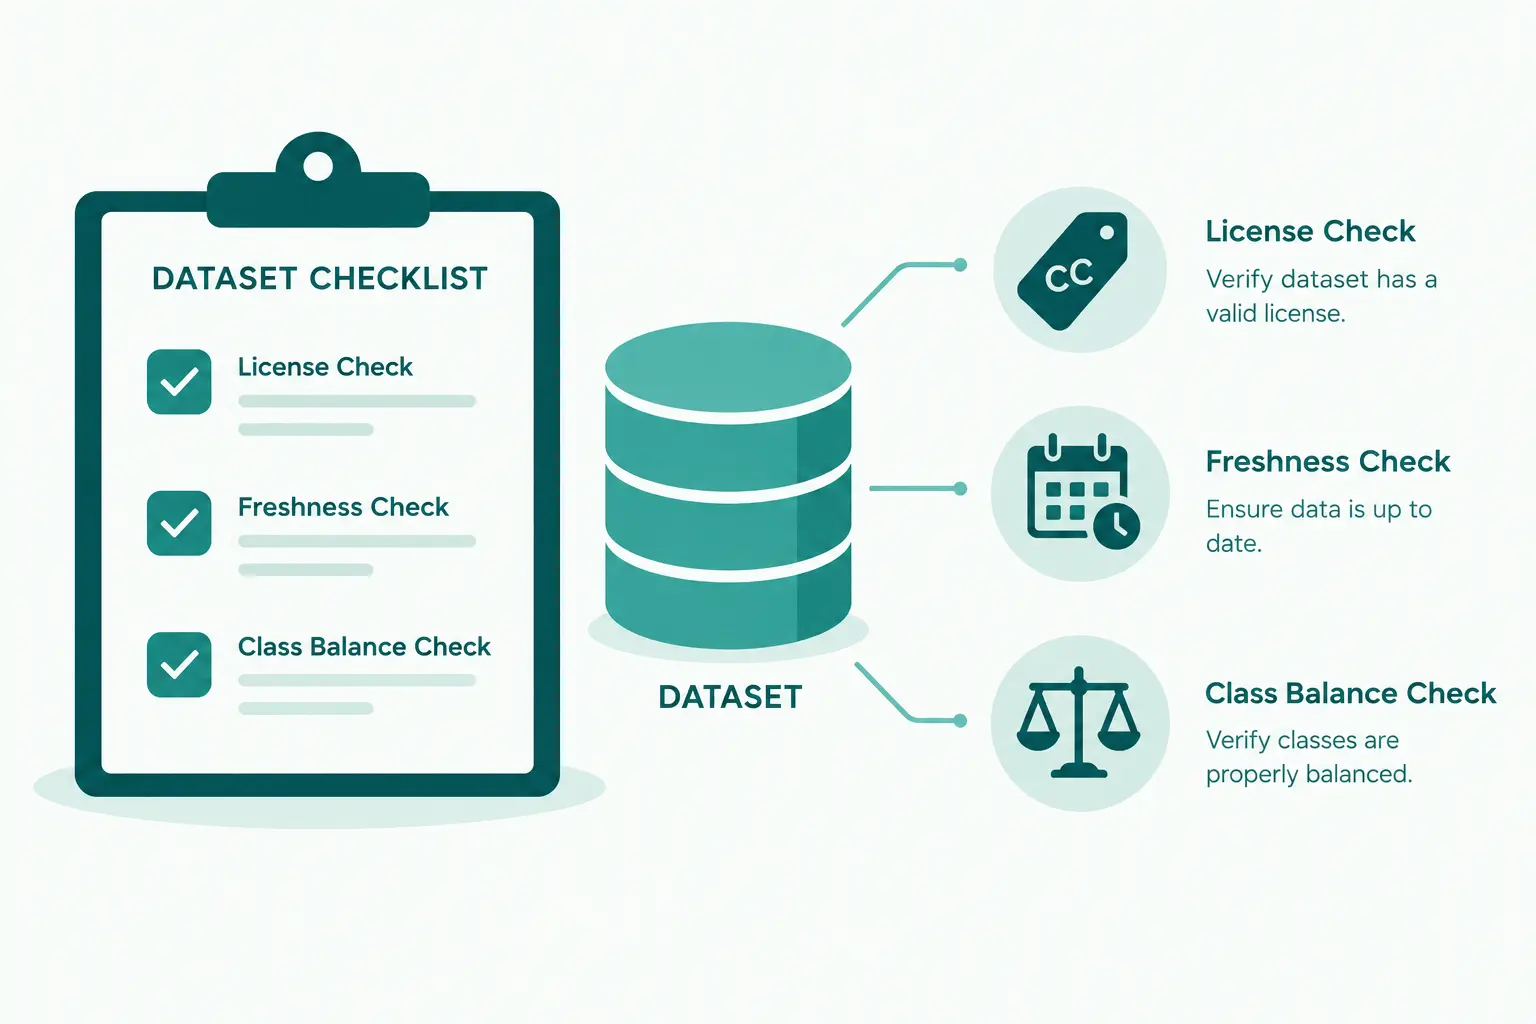
Hangi kaynaktan alırsanız alın, bir veri setini tezinize dahil etmeden önce şu kontrolleri yapın:
- Lisans/kullanım koşulları: veri setinin akademik kullanıma açık olduğunu, ticari kısıtlama taşımadığını kontrol edin; Kaggle veri setlerinin çoğu bir lisans etiketiyle (örneğin CC0, CC BY) işaretlidir, UCI’deki veri seti sayfaları da lisansı belirtir (örneğin klasik Iris veri seti CC BY 4.0 lisanslıdır).
- Eksik veri (missing values) oranı: yüksek oranda eksik veri taşıyan bir veri seti, ön işleme aşamasında ciddi zaman alabilir; veri setini seçmeden önce bu oranı hızlıca kontrol edin.
- Güncellik: özellikle hızlı değişen alanlarda (ekonomi, sağlık, teknoloji kullanımı) eski bir veri seti bulgularınızın güncelliğini zayıflatabilir.
- Örneklem temsiliyeti: veri setinin hangi popülasyonu (hangi ülke, hangi dönem, hangi demografik grup) temsil ettiğini anlayın; bulgularınızı genellemeye çalışırken bu kapsamı aşmayın.
- Sınıf dengesizliği (class imbalance): sınıflandırma projelerinde bir sınıfın diğerlerine göre çok daha az temsil edildiği veri setleri, standart doğruluk metriğini yanıltıcı hâle getirebilir; veri setini seçerken sınıf dağılımını kontrol edin.
Tekrarlanabilirlik: veri sürümünü ve indirme tarihini kaydedin
Kaggle ve açık veri portallarındaki veri setleri zaman içinde güncellenebilir veya kaldırılabilir. Tezinizi savunma tarihinize kadar tekrarlanabilir kılmak için, kullandığınız veri setinin sürüm numarasını (varsa), indirme tarihini ve mümkünse dosyanın bir kopyasını (veya bir sağlama/hash değerini) kaydedin. Bu küçük alışkanlık, jüri “bu veriyi nereden aldınız, hâlâ erişilebilir mi” diye sorduğunda net bir cevap vermenizi sağlar — bir yıl önce indirdiğiniz bir veri setinin bugün platformdan kaldırılmış olması, sizin metodolojik titizliğinizi sorgulatmaz, ama bunu belgelememiş olmanız sorgulatır.
Varsayımsal bir örnek: müşteri kaybı (churn) tahmini
Aşağıdaki senaryo tamamen kurgusaldır. Bir veri bilimi öğrencisi, telekomünikasyon sektöründe müşteri kaybını (churn) tahmin eden bir sınıflandırma modeli geliştirmek istediğini varsayalım. Bu, Türkiye’ye özgü bir soru olmadığından, önce Kaggle’da benzer bir “telecom churn” veri seti aranır; bulunan veri setinin sayfasında belirtilen orijinal kaynak (kurgusal olarak, bir telekom şirketinin anonimleştirilmiş müşteri kayıtları) kaynakçaya eklenir. Model geliştirildikten sonra, bulguların Türkiye pazarına genellenip genellenemeyeceği tartışma bölümünde ayrıca ele alınır — çünkü veri seti başka bir ülkenin pazarından toplanmıştır ve tüketici davranışı ülkeler arasında farklılık gösterebilir. Bu sınırlılığı açıkça belirtmek, tezin metodolojik dürüstlüğünü güçlendirir. Aynı senaryoda öğrenci, veri setini indirdiği tarihi ve Kaggle sayfasındaki sürüm bilgisini yöntem bölümüne not eder; böylece savunmada birisi veri setinin güncel durumunu sorguladığında, hangi sürümle çalıştığını kesin biçimde gösterebilir.
Sık yapılan dört hata
- Veri setinin orijinal kaynağını araştırmadan “Kaggle’dan alındı” demek. Kaggle bir barındırma platformudur, verinin kendisinin kaynağı değildir; orijinal kaynağı bulup kaynakçanıza ekleyin.
- Lisans koşullarını kontrol etmemek. Bazı veri setleri yalnızca eğitim amaçlı kullanıma izin verir; tezinizin yayımlanma biçimine (YÖK Ulusal Tez Merkezi’nde açık erişim) göre bu koşulu kontrol edin.
- Başka bir ülkeden alınan veri setinin bulgularını doğrudan Türkiye’ye genellemek. Veri setinin coğrafi ve demografik kapsamını aşan bir genelleme yapmaktan kaçının; bu sınırlılığı tartışma bölümünde belirtin.
- Veri setinin sürümünü ve indirme tarihini kaydetmemek. Açık veri kaynakları zaman içinde değişebilir; savunma sırasında veriye erişim sorulduğunda net bir cevap verebilmek için sürüm ve tarih bilgisini saklayın.
Veri setiniz hazır, tez metni kaldıysa
Tesify ile veri seti, yöntem ve bulgular bölümlerinizi yapılandırılmış biçimde yazmaya başlayabilirsiniz — kullandığınız veri setinin kaynağını ve özelliklerini ilettiğinizde bölüm iskeleti hazır gelir, analiz ve yorumlama sizin elinizde kalır. Akademik veri tabanı erişimi için EKUAL akademik veri tabanı erişimi yazımıza, tezinizdeki bir sayıyı doğrulamak için kaynak ve mevzuat doğrulama rehberimize, hangi analiz programını seçeceğinize dair SPSS, jamovi ve JASP karşılaştırma yazımıza bakabilirsiniz.
Sık sorulan sorular
Veri bilimi tezim için hangi kaynaktan başlamalıyım?
Sorunuz Türkiye’ye özgüyse TÜİK’ten veya ilgili kamu/belediye açık veri portalından, genel bir makine öğrenmesi problemiyse Kaggle’dan, literatürle karşılaştırma yapacaksanız alanınızın standart benchmark veri setinden başlayın.
Kaggle veri setlerini tezimde kullanabilir miyim?
Çoğu zaman evet, ancak veri setinin lisansını ve orijinal kaynağını kontrol edip kaynakçanıza doğru atıfla eklemeniz gerekir.
TÜİK verileri neden bazen yetersiz kalıyor?
TÜİK verileri genellikle toplulaştırılmış tablolar hâlindedir; bireysel gözlem düzeyinde ham veri gerektiren makine öğrenmesi projeleri için her zaman yeterli olmayabilir.
UCI Machine Learning Repository ile Kaggle arasındaki fark ne?
UCI daha az veri seti barındırır ama genellikle her setin kökeni daha ayrıntılı belgelenmiştir; Kaggle çok daha geniş ama kullanıcı katkılı bir platformdur, kaynağı kendiniz doğrulamanız gerekir.
Başka bir ülkeden alınan veri setiyle çalışabilir miyim?
Evet, ancak bulgularınızı Türkiye’ye veya başka bir bağlama genellerken bu sınırlılığı tartışma bölümünde açıkça belirtmeniz gerekir.
Veri setinin lisansını nereden kontrol ederim?
Kaggle ve UCI’daki veri seti sayfalarında genellikle bir lisans bilgisi (CC0, CC BY gibi) belirtilir; bu bilgiyi tezinizde kullanmadan önce kontrol edin.
Eksik veri oranı yüksek bir veri setini kullanmalı mıyım?
Kullanabilirsiniz, ancak ön işleme sürecinde ciddi zaman gerektirebilir; veri setini seçmeden önce eksik veri oranını kontrol edip buna göre plan yapın.
Kendi veri setimi toplarsam ne yapmalıyım?
Toplama tarihini, yöntemini ve kapsamını tezinizde ayrıntılı belgeleyin; bu, tekrarlanabilirlik açısından jüri önünde sıkça sorulan bir konudur.
Web kazıma (web scraping) ile veri toplayabilir miyim?
Evet, ancak platformun kullanım şartlarına uygun olduğundan, kişisel veri içermediğinden (veya uygun şekilde anonimleştirildiğinden) ve toplama sürecinin tekrarlanabilir biçimde belgelendiğinden emin olun; bu üç noktayı danışmanınızla önceden konuşun.
Sentetik veri kullanmak akademik olarak kabul edilir mi?
Gizlilik riski taşıyan veya erişimi kısıtlı konularda kabul edilebilir bir yaklaşımdır, ancak bunu tezinizde açıkça belirtmeniz ve mümkünse bulgularınızı küçük bir gerçek veri örneklemiyle doğrulamanız beklenir.
Sınıf dengesizliği olan bir veri setini nasıl anlarım?
Veri setinin hedef değişkenindeki sınıfların dağılımını (kaç gözlem hangi sınıfa ait) inceleyin; bir sınıf diğerlerinden çok daha az temsil ediliyorsa, standart doğruluk metriği yanıltıcı olabilir ve farklı bir değerlendirme metriği gerekebilir.