Bilgisayar mühendisliği tezinde en çok takılınan yer, ilk sayfa değil, bölümlerin birbirine nasıl bağlandığıdır: problem tanımı literatürle, literatür yöntemle, yöntem bulgularla, bulgular da sonuçla örtüşmelidir. Aşağıda, konudan sonuca uçtan uca çalışan, anotasyonlu bir örnek model bulacaksınız — yöntem bölümünü ayrıntılı biçimde nasıl yazacağınızı zaten öğrenmek istiyorsanız sitemizdeki yöntem bölümü rehberimize bakabilirsiniz; bu yazı ise tezin tamamının nasıl bir bütün oluşturduğunu gösterir.
Bilgisayar mühendisliği tezinde “uçtan uca” ne demek?
Bu yazıda “uçtan uca model” ifadesi, tek bir bölümü değil, altı bölümün (problem tanımı, literatür, yöntem, bulgular, tartışma, sonuç) birbirini nasıl beslediğini gösteren bütüncül bir örneği ifade eder. Birçok kaynak yalnızca tek bir bölümü (örneğin yalnızca yöntem veya yalnızca literatür yazımı) ayrıntılı işler; bu yazının amacı, o bölümlerin tek başlarına değil, bir bütün olarak nasıl bir tez oluşturduğunu göstermektir. Aşağıdaki örnek konuyu ve verileri birebir kopyalamak yerine, bölümler arasındaki bu bağlantı mantığını kendi konunuza taşımanız beklenir.
Örnek tez konusu ve problem tanımı nasıl yazılır?
Örnek konumuz: “Küçük ölçekli yazılım ekiplerinde kod inceleme (code review) süresinin, hata yoğunluğu ile ilişkisi.” Problem tanımı üç cümlede kurulur: (1) gözlemlenen durum — küçük ekiplerde kod inceleme süreleri genellikle tutarsızdır; (2) bilinmeyen — bu tutarsızlığın üretime giden hata sayısıyla ilişkisi sistematik olarak ölçülmemiştir; (3) çalışmanın amacı — bu ilişkiyi açık kaynaklı proje verileriyle nicel olarak incelemek. İyi bir problem tanımı, “kimsenin bilmediği bir şey” değil, “sistematik olarak ölçülmemiş bir şey” iddiasında bulunur — bu, jürinin en çok sorduğu “bu çalışmanın katkısı ne?” sorusuna baştan cevap verir.
Literatür taraması nasıl yapılandırılır?
Bilgisayar mühendisliği tezlerinde literatür bölümü genellikle üç katmanda kurulur: (1) geniş bağlam — yazılım kalitesi ve kod inceleme literatürünün genel bir özeti, (2) daralan odak — kod inceleme süresi ve hata yoğunluğu ilişkisini doğrudan inceleyen çalışmalar, (3) boşluk — küçük ekiplerde (5 kişiden az) bu ilişkinin ayrıca incelenmediği noktası. Her katman, bir öncekinden daha dar olmalı ve son katman doğrudan sizin araştırma sorunuza açılmalıdır. Kaynakları kronolojik değil, tematik olarak gruplamak (örneğin “metrik tabanlı çalışmalar” ve “anket tabanlı çalışmalar” gibi) literatürünüzü bir liste değil bir tartışma haline getirir.
Yöntem bölümü: bu örnekte hangi yaklaşım kullanıldı?
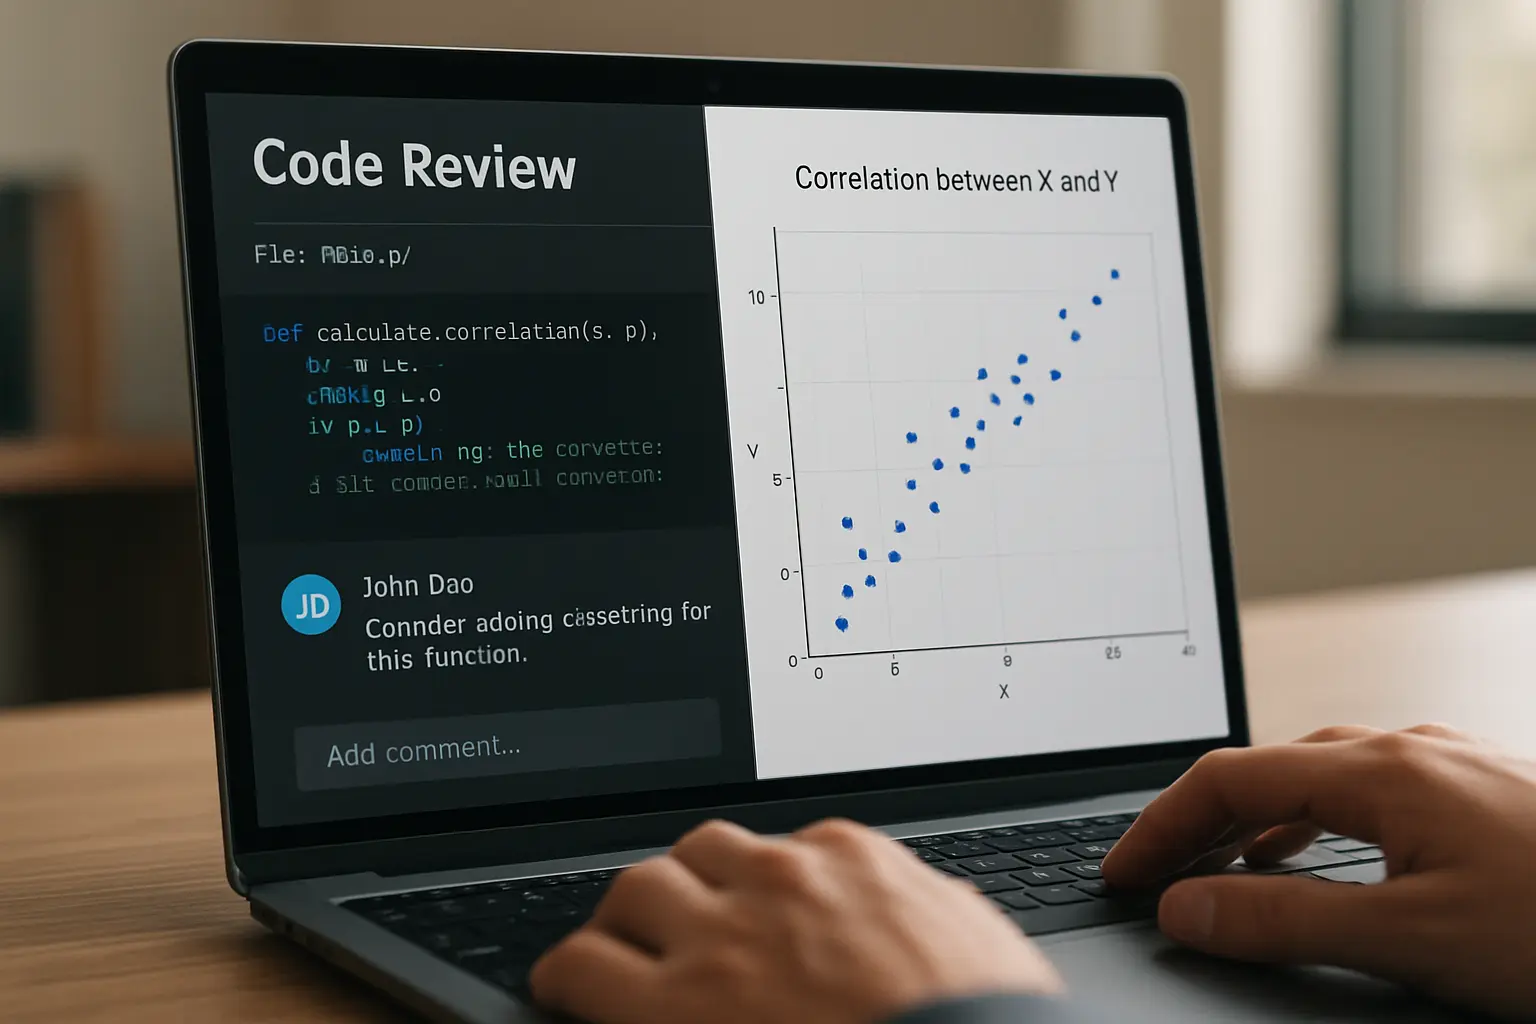
Örnek çalışmamız, GitHub üzerinde herkese açık 30 küçük ölçekli açık kaynak deposundan pull request meta verilerini (inceleme süresi, yorum sayısı, sonraki 30 gün içindeki hata kaydı sayısı) çekip korelasyon ve çoklu regresyon analizi uygulayan nicel bir tasarımdır. Yöntem bölümünde mutlaka şunlar netleştirilir: veri kaynağı ve erişim şekli (API, hangi tarih aralığı), dahil etme/hariç tutma ölçütleri (örneğin en az 6 aylık aktif geçmişi olan depolar), bağımlı ve bağımsız değişkenlerin operasyonel tanımları, kullanılan istatistiksel test ve varsayımların nasıl kontrol edildiği. Bu adımların her birinin ayrıntılı yazımı için yukarıda bağlantısı verilen yöntem bölümü rehberimiz daha derin bir referans sağlar; burada odak, yöntemin tezin bütünü içindeki yeridir.
Bulgular özeti nasıl sunulur? (varsayımsal örnek veri)
Aşağıdaki sayılar yalnızca bulgular bölümünün nasıl yazılacağını göstermek için üretilmiş varsayımsal örnek verilerdir, gerçek bir araştırmanın sonucu değildir.
| Değişken | Varsayımsal ilişki | Yazım biçimi |
|---|---|---|
| İnceleme süresi × hata yoğunluğu | Orta düzey negatif korelasyon (varsayımsal r ≈ -0,3) | “İnceleme süresi ile sonraki hata kaydı sayısı arasında istatistiksel olarak anlamlı, orta düzeyde negatif bir ilişki gözlenmiştir.” |
| Ekip büyüklüğü × ilişkinin gücü | Küçük ekiplerde ilişki daha belirgin (varsayımsal) | “Bu ilişki, 5 kişiden küçük ekiplerde daha güçlü gözlenmiştir; bu durum ek bir alt analiz gerektirmiştir.” |
| Yorum sayısı × hata yoğunluğu | Zayıf, anlamsız ilişki (varsayımsal) | “Yorum sayısının tek başına anlamlı bir yordayıcı olmadığı görülmüştür.” |
Bulgular bölümünün altın kuralı: yalnızca test sonuçlarını raporlayın, yorumu tartışma/sonuç bölümüne bırakın. “Bu, ekiplerin daha yavaş inceleme yapması gerektiği anlamına gelir” gibi bir yorum cümlesi bulgular bölümünde değil, sonuç bölümünde yer almalıdır.
Sonuç ve öneriler bölümü nasıl kapanır?
Sonuç bölümü dört unsuru sırayla kapatır: (1) araştırma sorusuna doğrudan cevap (bir-iki cümle), (2) bulgunun literatürle nasıl örtüştüğü veya çeliştiği, (3) çalışmanın sınırlılıkları (örneğin örneklem büyüklüğü, yalnızca açık kaynak projelerle sınırlı olması), (4) somut ve uygulanabilir bir öneri (örneğin küçük ekipler için minimum inceleme süresi eşiği önerisi). Sonuç bölümünü asla yeni bir bulgu veya yeni bir kaynakla açmayın — bu bölüm sentezdir, yeni bilgi tanıtımı değildir.
Tartışma bölümü sonuç bölümünden nasıl ayrılır?
Birçok öğrenci “tartışma” ve “sonuç” bölümlerini aynı şey sanıp birleştirir, oysa ikisinin işlevi farklıdır. Tartışma bölümü, bulgularınızı literatürle karşılaştırdığınız, “neden bu sonucu bulduk” sorusunu ele aldığınız, alternatif açıklamaları değerlendirdiğiniz yerdir — burada spekülasyon yapmanıza (gerekçelendirilmiş biçimde) izin vardır. Sonuç bölümü ise çok daha kısa ve kesindir: araştırma sorusuna doğrudan cevap, katkı, sınırlılık, öneri. Örnek tezimizde tartışma bölümü şöyle açılabilir: “Bulunan negatif korelasyon, [X] çalışmasının bulgularıyla örtüşürken, [Y] çalışmasının aksine ekip büyüklüğünün ilişkiyi güçlendirdiği gözlenmiştir; bu fark, örneklemimizin yalnızca açık kaynak projelerinden oluşmasıyla açıklanabilir.” Bu iki bölümü ayrı tutmak, hem savunmada hem yazımda tezinizin daha profesyonel görünmesini sağlar.
Bilgisayar mühendisliği tezlerinde sık yapılan üç hata
- Araştırma sorusunu çok geniş tutmak. “Yapay zekâ yazılım geliştirmeyi nasıl etkiler?” gibi bir soru bir tez için fazla geniştir; “kod tamamlama araçlarının küçük ekiplerde inceleme süresine etkisi” gibi daraltılmış bir soru hem yönetilebilir hem savunulabilirdir.
- Veri kümesini seçtikten sonra araştırma sorusunu ona uydurmaya çalışmak. Doğru sıralama tam tersidir: önce soru, sonra sorunun cevaplanabileceği bir veri kaynağı arayışı — aksi halde bulgularınız sorunuzla zayıf bağlanır.
- Sınırlılıklar bölümünü savunmacı bir dille yazmak. “Zaman kısıtı nedeniyle…” gibi özür diler bir ton yerine, “Bu çalışma [X] kapsamıyla sınırlıdır; bu sınırlılık, bulguların [Y] bağlamına genellenmesini kısıtlar” gibi metodolojik bir çerçeve, aynı sınırlılığı çok daha güçlü sunar.
Bilgisayar mühendisliği tezlerinde sık kullanılan üç konu türü
- Ampirik yazılım mühendisliği çalışmaları. Yukarıdaki örnek gibi, gerçek veya açık kaynak verisi üzerinden bir yazılım geliştirme pratiğinin etkisini ölçen çalışmalar.
- Sistem/algoritma geliştirme ve karşılaştırma çalışmaları. Yeni bir algoritma veya sistem mimarisi önerip mevcut yöntemlerle standart veri kümeleri üzerinde karşılaştıran çalışmalar.
- Kullanıcı çalışmalı (HCI) tezler. Bir arayüz veya araç tasarımının kullanıcı performansına etkisini ölçen, katılımcı gerektiren çalışmalar — bu türde örneklem büyüklüğü hesaplaması ayrıca önem kazanır.
Kod ve deney tekrarlanabilirliği neden önemli?
Bilgisayar mühendisliği tezlerinde jürinin sıkça sorduğu ama öğrencilerin genelde hazırlıksız yakalandığı bir soru: “Bu deneyi başka biri tekrarlayabilir mi?” Tekrarlanabilirlik için asgari olarak şunlar tez ekinde veya bir bağlantıda bulunmalıdır: kullanılan veri kümesinin kaynağı ve erişim koşulları, ön işleme adımlarının tam listesi, kullanılan yazılım/kütüphane sürümleri, varsa kod deposunun bağlantısı. Bu bilgilerin eksikliği, savunma sırasında en sık karşılaşılan eleştirilerden biridir ve kolayca önlenebilir bir hatadır — yazım sürecinin en başından itibaren bir “tekrarlanabilirlik günlüğü” tutmak, tez bitiminde bu bölümü yeniden oluşturma zahmetinden kurtarır.
Kullanıcı çalışması içeren tezlerde örneklem büyüklüğü nasıl belirlenir?
HCI veya kullanıcı deneyimi odaklı bilgisayar mühendisliği tezlerinde, katılımcı sayısı genellikle danışmanla en çok tartışılan konulardan biridir. Etki büyüklüğü ve istatistiksel güç mantığına dayanan hesaplama adımlarını genel hatlarıyla örneklem büyüklüğü rehberimizde bulabilirsiniz; bilgisayar mühendisliğinde bu hesaplama, katılımcı bulma zorluğu nedeniyle çoğu zaman ideal sayıdan biraz daha düşük ama gerekçelendirilmiş bir örneklemle sonuçlanır — bu sapmanın sınırlılıklar bölümünde açıkça belirtilmesi beklenir.
Veri toplama sürecinde lisans ve kullanım şartları neden önemli?
Açık kaynak depoları veya API’lar üzerinden veri toplarken gözden kaçan bir adım, verinin kullanım şartlarını (Terms of Service, lisans dosyası) kontrol etmektir. GitHub gibi platformların API kullanım politikaları, toplu veri çekme (scraping) hızını ve amacını sınırlayabilir; bazı depolar akademik kullanım için açık olsa da ticari kullanım için farklı bir lisans taşıyabilir. Yöntem bölümünüzde hangi lisans koşulları altında hangi veriyi topladığınızı bir cümleyle belirtmek, hem etik hem metodolojik olarak tezinizi güçlendirir. Kişisel veri içerebilecek alanlar (kullanıcı adı, e-posta gibi) varsa, bunları analiz öncesi anonimleştirmek veya toplamamak, kurumunuzun etik kurul sürecini de kolaylaştırır.
Jüri bu örnek modelde neyi arar?
Savunma jürisi, bölümlerin ayrı ayrı iyi yazılmış olmasından çok, aralarındaki tutarlılığı değerlendirir: literatürde bahsedilmeyen bir değişken bulgularda aniden ortaya çıkmamalı, yöntemde tanımlanmayan bir analiz sonuçlarda kullanılmamalı, sonuçta iddia edilen bir katkı problem tanımında zaten söz verilmiş olmalıdır. Bu örnek modeldeki her bölüm, bir öncekine doğrudan referans verecek şekilde yazılmıştır — kendi tezinizi gözden geçirirken her bölümün bir öncekiyle ve tez sorusuyla hâlâ örtüştüğünü kontrol etmeniz, savunmada karşılaşacağınız en yaygın eleştiriyi baştan önler.
Kaynakça ve atıf biçimi bilgisayar mühendisliğinde nasıl farklılaşır?
Bilgisayar mühendisliği tezlerinde APA yerine sıklıkla IEEE atıf biçimi tercih edilir — metin içinde köşeli parantez içinde numara (örneğin [3]), kaynakçada ise kullanım sırasına göre numaralandırılmış liste. Bu, sosyal bilimlerdeki yazar-tarih (APA) sistemine göre önemli bir farktır ve bölümünüzün hangi biçimi beklediğini yazmaya başlamadan önce netleştirmeniz gerekir. Ayrıca konferans bildirileri (proceedings) bilgisayar mühendisliğinde dergilerle eşit ölçüde saygın kaynaklar sayılabilir — ACM, IEEE gibi büyük konferansların bildirileri, alanın literatüründe sıradan bir dergi makalesinden daha güncel ve etkili olabilir; kaynakçanızda bu tür kaynakları dışlamamanız önerilir.
Kendi tezinize nasıl uyarlarsınız?
Kendi konunuzu alın, yukarıdaki altı bölümü (problem→literatür→yöntem→bulgular→tartışma→sonuç) aynı sırayla doldurun, her bölümün bir öncekine açıkça referans verdiğinden emin olun ve tekrarlanabilirlik bilgilerini eklerde toplayın. Tesify’ın yapay zekâ editörü ile tezinizi bu altı bölüm iskeletine oturtarak yazmaya başlayabilirsiniz — bölüm tutarlılığı kontrolü hazır gelir, konunuz, veri kaynağınız ve kodunuz baştan sona sizin kalır.
Sık sorulan sorular
Bu örnek modeldeki gibi açık kaynak veri kullanmak zorunda mıyım?
Hayır — açık kaynak veri, erişim kolaylığı nedeniyle sık tercih edilir, ama kendi kurumunuzun veya bir şirketin verisiyle de (izin dahilinde) benzer bir yapı kurabilirsiniz; bölümler arası mantık aynı kalır.
Nicel değil nitel bir bilgisayar mühendisliği tezi yazabilir miyim?
Evet, özellikle yazılım geliştirme süreçlerini, geliştirici deneyimini veya araç benimsemesini inceleyen çalışmalarda görüşme veya vaka çalışması temelli nitel tasarımlar da kabul görür; bölüm sırası (problem→literatür→yöntem→bulgular→sonuç) aynı kalır, yöntem ve bulgular bölümlerinin içeriği değişir.
Algoritma geliştirme temelli bir tezde bulgular bölümü nasıl farklılaşır?
Bulgular bölümü genellikle önerilen yöntemin, standart veri kümeleri üzerinde mevcut yöntemlerle karşılaştırmalı performans tablosu (doğruluk, çalışma süresi, bellek kullanımı gibi metrikler) şeklinde sunulur; yorum yine sonuç bölümüne bırakılır.
Literatür taramasında kaç kaynak yeterli sayılır?
Sabit bir sayı yoktur — danışmanınızın ve bölümünüzün beklentisi belirleyicidir; önemli olan sayıdan çok, kaynakların üç katmanlı yapıyı (geniş bağlam→daralan odak→boşluk) gerçekten destekleyip desteklemediğidir.
Tez önerisi aşamasında bulgular bölümünü önceden yazabilir miyim?
Hayır, ama bulgular bölümünün nasıl raporlanacağının planını (hangi testler, hangi tablolar) önerinizde belirtmeniz beklenir; bu, veri toplama aşamasına geçtiğinizde zaman kazandırır.
Kod deposu paylaşmak zorunlu mu?
Çoğu bölümde zorunlu değildir, ama tekrarlanabilirlik açısından şiddetle önerilir; danışmanınız ve kurumunuzun veri/kod paylaşım politikasını önceden kontrol edin.
Tek bir veri kümesi yerine birden fazla veri kümesiyle çalışmak gerekli mi?
Gerekli değildir, ama bulgularınızın genellenebilirliğini güçlendirir; tek veri kümesiyle çalışıyorsanız bu, sınırlılıklar bölümünde açıkça belirtilmesi gereken bir noktadır.
Yöntem bölümünde hangi istatistiksel testi seçeceğimi nasıl bilirim?
Seçim, değişkenlerinizin ölçüm düzeyine (sürekli/kategorik) ve araştırma sorunuzun ilişki mi yoksa fark mı sorduğuna bağlıdır; danışmanınızla veya bir istatistik danışmanlık biriminizle erken aşamada bu seçimi netleştirmek, veri toplandıktan sonra yöntem değiştirme riskini azaltır.
Bulgular beklediğim yönde çıkmazsa tezimi nasıl toparlarım?
Beklenmeyen bulgular bir sorun değil, tartışma bölümünde ele alınacak bir bulgudur — literatürle neden çeliştiğini tartışmak, hipotezinizi doğrulayan bir sonuçtan çoğu zaman daha değerli bir katkı olabilir.
Bu örnek modeldeki gibi bir konuyu birebir kullanabilir miyim?
Birebir kullanmak önerilmez; konu, veri kaynağı ve değişkenler kendi ilginize ve erişiminize göre değişmelidir — kopyalanması gereken şey konu değil, bölümler arası mantıksal akıştır.
Danışmanımla ilk toplantıda hangi soruları netleştirmeliyim?
En az şunları netleştirin: hangi veri kaynağına erişiminiz olacak, hangi istatistiksel/analitik yöntemin bölümünüzde kabul gördüğü, kod/veri paylaşımı konusunda kurumsal bir politika olup olmadığı ve tez önerisi ile savunma arasında kaç ilerleme toplantısı beklendiği.
Tek bir bulgu tablosu yerine birden fazla analiz sunmam gerekir mi?
Araştırma sorunuzun karmaşıklığına bağlıdır; tek bir net tablo, dağınık birçok küçük analizden çoğu zaman daha güçlüdür — önemli olan analiz sayısı değil, her analizin araştırma sorunuzla doğrudan bağlantılı olmasıdır.
IEEE ve APA atıf biçimlerini aynı tez içinde karıştırabilir miyim?
Hayır, bir tez tek bir atıf biçimini tutarlı biçimde kullanmalıdır; bölümünüzün hangi biçimi zorunlu kıldığını yazım kılavuzundan veya danışmanınızdan öğrenip baştan o biçimle çalışmak, tez teslim öncesi büyük bir yeniden biçimlendirme zahmetinden kurtarır.
Bu örnek modeldeki gibi bir tez ne kadar sürede yazılabilir?
Süre, veri toplama yönteminize (hazır açık veri mi, kendi topladığınız veri mi) ve analiz karmaşıklığınıza göre büyük ölçüde değişir; hazır bir açık veri kümesiyle çalışan nicel bir çalışma, kendi kullanıcı deneyinizi tasarlayıp yürüttüğünüz bir HCI çalışmasından genellikle daha kısa sürer. Aşamaları takvime dökmek için tez yazma takvimi rehberimize bakabilirsiniz.