Bilgisayar mühendisliği tezinde yöntem bölümü, sosyal bilim tezinden farklı bir mantıkla ilerler: burada “yöntem” bir anket dağıtmak değil, bir sistemi veya modeli, belirli bir veri kümesi üzerinde, önceden tanımlanmış bir deney düzenine göre, ölçülebilir metriklerle test etmektir. Bu yazıda bu üç adımı — veri kümesi seçimi, deney düzeni ve karşılaştırma — sırasıyla ele alıyoruz.
Bu üç adım aynı zamanda bir tezin “yeniden üretilebilir mi” sorusuna verdiği cevabın omurgasıdır. Bilgisayar mühendisliği alanında son yıllarda artan bir titizlik beklentisi var: jüriler artık sadece “model çalıştı mı” değil, “başka biri aynı sonucu tekrar elde edebilir mi” sorusunu da soruyor. Aşağıdaki iskelet, bu beklentiyi karşılayacak düzeyde ayrıntı vermenizi sağlar.
Adım 1: Veri kümesi nasıl seçilir ve raporlanır?
Veri kümesi seçimi, tezin tekrarlanabilirliğinin temelidir. İyi bir veri kümesi paragrafı şu beş unsuru içerir: kümenin adı ve kaynağı, boyutu (örnek sayısı, sınıf sayısı), toplanma veya etiketlenme yöntemi, eğitim/doğrulama/test bölünmesi (train/validation/test split) ve varsa bilinen sınırlılıkları.
Örnek cümle: “Bu çalışmada görüntü sınıflandırma modelinin eğitimi için CIFAR-10 veri kümesi kullanılmıştır; küme 10 sınıfa ait 60.000 renkli görüntüden oluşmakta olup standart bölünmeye göre 50.000 eğitim ve 10.000 test görüntüsüne ayrılmıştır.” Kendi çalışmanız için özgün bir veri kümesi topluyorsanız, toplama sürecini (kaynak, zaman aralığı, etiketleme protokolü, etiketleyiciler arası uyum ölçütü) ayrı bir alt başlıkta anlatmanız beklenir.
Halka açık bir kıyaslama (benchmark) kümesi kullanmıyorsanız, veri kümesinin nasıl toplandığını ve önyargı (bias) kaynaklarını açıkça tartışmanız jüri tarafından beklenir; bu, sosyal bilim tezindeki örneklem temsil gücü tartışmasının bilgisayar mühendisliğindeki karşılığıdır. Özgün bir veri kümesi kullanan tezlerde, etiketleyiciler arası uyum genellikle Cohen kappa veya Krippendorff alfa gibi bir katsayı ile raporlanır; bu katsayı düşükse (ör. 0,60’ın altında) etiketleme protokolünün gözden geçirildiği ayrı bir paragraf eklenmelidir.
| Veri kümesi türü | Raporlanması gereken temel bilgi |
|---|---|
| Halka açık benchmark (CIFAR-10, ImageNet, GLUE vb.) | Ad, kaynak, standart bölünme, sürüm numarası |
| Özgün toplanan veri | Toplama kaynağı, zaman aralığı, etiketleme protokolü, etiketleyiciler arası uyum |
| Sentetik / üretilmiş veri | Üretim yöntemi, gerçek veriyle karşılaştırma, sentetik olduğunun açık belirtilmesi |
Tam bir yöntem paragrafı örneği nasıl görünür?
Aşağıdaki örnek, e-posta spam tespiti üzerine bir tezin yöntem bölümünden alınmıştır ve yukarıdaki üç adımın tamamını gösterir:
“Bu çalışmada spam e-posta sınıflandırması için Enron-Spam veri kümesi kullanılmıştır; küme 33.716 e-postadan (17.171 spam, 16.545 normal) oluşmakta olup rastgele örnekleme ile %70 eğitim, %15 doğrulama, %15 test olarak bölünmüştür. Önerilen ince ayarlı BERT tabanlı sınıflandırıcı, iki temel modelle karşılaştırılmıştır: TF-IDF özellik çıkarımı ile lojistik regresyon ve çok katmanlı algılayıcı (MLP). Tüm modeller Adam eniyileyici, 2e-5 öğrenme oranı (BERT için) ve 32 batch boyutuyla, tek bir NVIDIA RTX 4090 GPU üzerinde, PyTorch 2.3 ve Hugging Face Transformers 4.4 ortamında, beş farklı sabit tohum değeriyle eğitilmiştir. Sınıflar dengeli dağıldığı için doğruluk (accuracy) birincil metrik olarak, F1-skoru ikincil metrik olarak raporlanmıştır. Önerilen modelin katkısını izole etmek için, ön işleme adımındaki alan adı normalizasyonunun çıkarıldığı bir ablasyon deneyi ayrıca yapılmıştır. Önerilen model ile en güçlü temel model arasındaki fark, eşleştirilmiş t-testi ile test edilmiştir.”
Bu paragrafta veri kümesi (ad, boyut, bölünme), deney düzeni (temel modeller, hiperparametreler, donanım, tohum, ablasyon) ve karşılaştırma (metrik seçimi ve anlamlılık testi) sırayla ve gerekçeli biçimde geçer. Kendi yöntem bölümünüzü yazarken bu paragrafı bir kontrol listesi gibi kullanıp hangi unsurun eksik kaldığını işaretleyebilirsiniz.
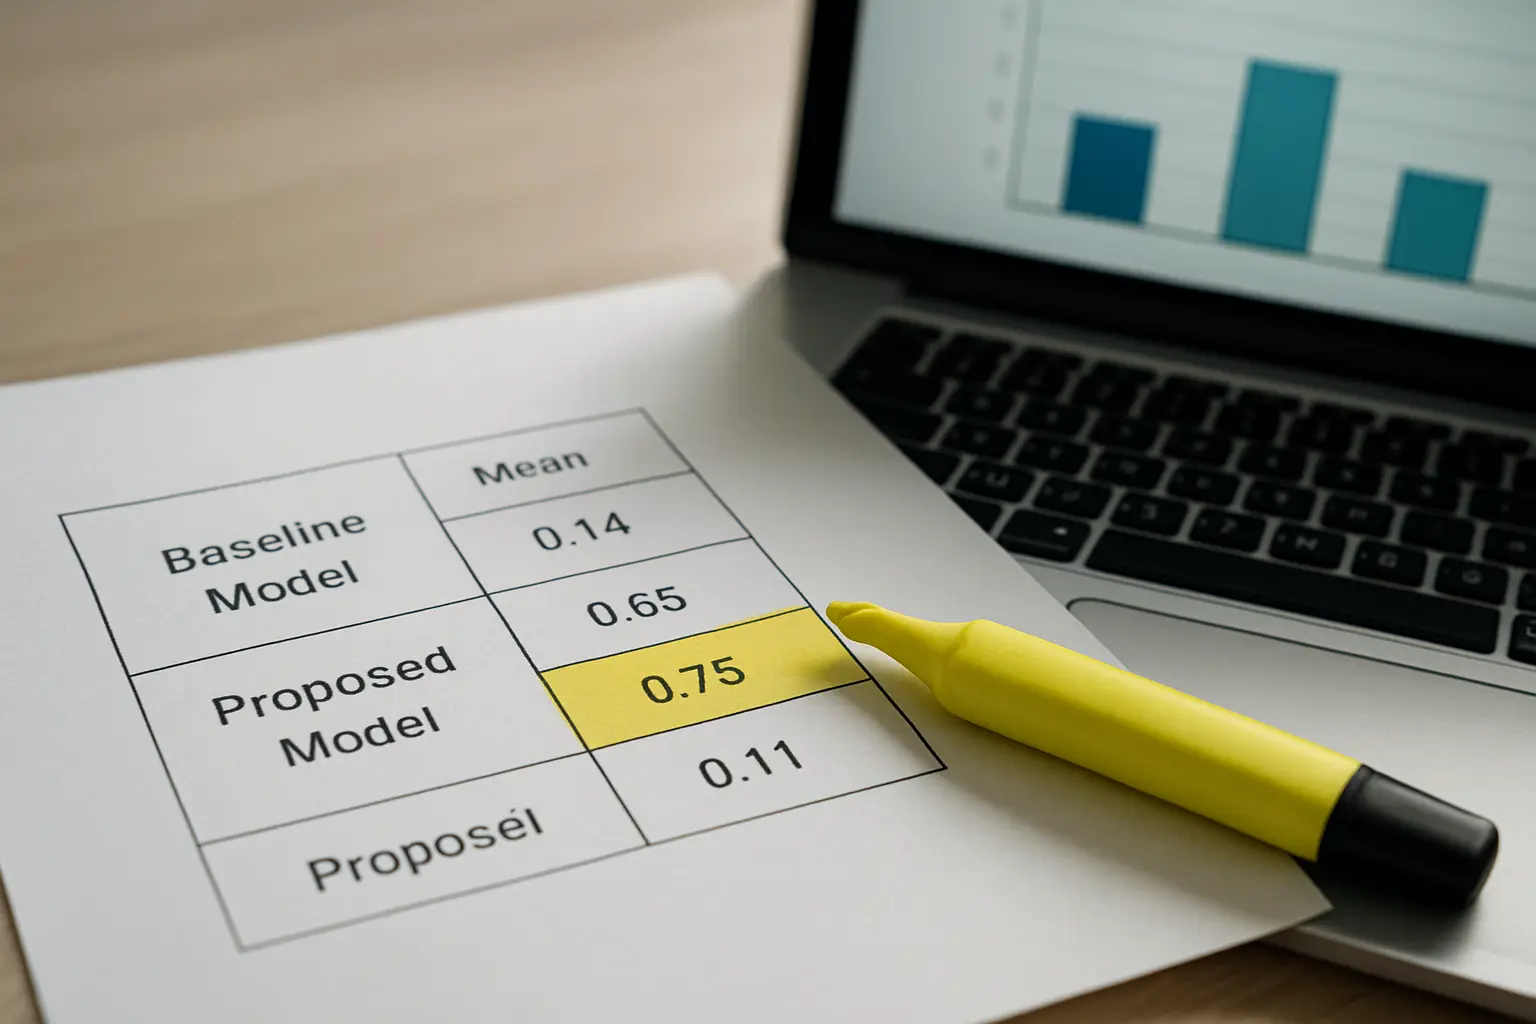
Bu örneğin Bulgular bölümünde nasıl bir sonuç tablosuna dönüştüğü de gösterilebilir; yöntem bölümünde tanımlanan her karşılaştırma noktası, Bulgular’da bir tablo satırına karşılık gelmelidir:
| Model | Doğruluk (ort. ± sd) | F1-skoru (ort. ± sd) |
|---|---|---|
| Lojistik regresyon (TF-IDF) | %91,4 ± 0,4 | 0,908 ± 0,005 |
| MLP (TF-IDF) | %93,1 ± 0,5 | 0,927 ± 0,006 |
| Önerilen (ince ayarlı BERT) | %96,7 ± 0,3 | 0,965 ± 0,004 |
Bu tablonun altında tek cümlelik bir özet yer almalıdır: “Önerilen model, en güçlü temel modele (MLP) göre doğrulukta 3,6 puanlık bir artış sağlamış ve bu fark eşleştirilmiş t-testine göre istatistiksel olarak anlamlı bulunmuştur (p<0,01).” Yöntem bölümünde tanımlanan her unsurun Bulgular’da karşılığını bulması, tezin iç tutarlılığının en açık göstergesidir.
Adım 2: Deney düzeni nasıl kurulur?
Deney düzeni, hangi modellerin hangi koşullarda karşılaştırılacağını önceden sabitler. Standart bir deney düzeni paragrafı şu bileşenleri içerir:
- Temel model (baseline) — önerilen yöntemin karşılaştırılacağı en az bir yerleşik yöntem.
- Hiperparametreler — öğrenme oranı, batch boyutu, epoch sayısı gibi değerler ve nasıl seçildikleri (grid search, random search, varsayılan değer).
- Donanım ve yazılım ortamı — kullanılan GPU/CPU modeli, çerçeve (PyTorch, TensorFlow) ve sürümü.
- Rastgelelik kontrolü — sabit tohum (random seed) değeri ve kaç kez tekrarlandığı.
- Ablasyon çalışması — önerilen yöntemin her bileşeninin katkısını izole etmek için bileşenlerin tek tek çıkarıldığı ek deneyler.
Ablasyon çalışması, özellikle önerilen bir yöntemin (ör. yeni bir dikkat mekanizması, yeni bir ön işleme adımı) katkısını kanıtlamak isteyen tezlerde neredeyse zorunlu hale gelmiştir; jüri sık sık “bu iyileşme gerçekten sizin önerdiğiniz bileşenden mi geliyor, yoksa başka bir faktörden mi” sorusunu sorar ve ablasyon tablosu bu soruya doğrudan cevap verir.
Deney düzenini yazarken sık atlanan bir nokta, doğrulama kümesinin (validation set) rolünü açıkça belirtmektir. Hiperparametre seçimi test kümesi üzerinde değil, ayrı bir doğrulama kümesi üzerinde yapılmalıdır; test kümesi yalnızca son değerlendirmede, bir kez kullanılmalıdır. Bu ayrımın yöntem bölümünde açıkça belirtilmemesi, jüri tarafından sıkça sorgulanan bir noktadır çünkü doğrulama ve test kümelerinin karıştırılması, raporlanan başarı oranını yapay olarak yükseltebilir.
Adım 3: Karşılaştırma hangi metriklerle yapılır?
Metrik seçimi probleme göre değişir ama her tez, seçtiği metriği neden seçtiğini gerekçelendirmelidir:
| Problem türü | Yaygın metrikler | Ne zaman tercih edilir |
|---|---|---|
| Sınıflandırma (dengeli veri) | Doğruluk (accuracy) | Sınıflar eşit dağılmışsa |
| Sınıflandırma (dengesiz veri) | Precision, recall, F1-skoru | Bir sınıf az temsil ediliyorsa |
| Regresyon | RMSE, MAE, R² | Sürekli değer tahmininde |
| Bilgi getirimi / sıralama | NDCG, MAP, Precision@k | Öneri sistemleri, arama |
Sadece nokta tahmini (ör. “doğruluk %94,2”) vermek yeterli değildir; birden fazla çalıştırmanın ortalaması ve standart sapması (ör. “%94,2 ± 0,6”) raporlanmalı, mümkünse istatistiksel anlamlılık testi (eşleştirilmiş t-testi veya Wilcoxon işaretli sıra testi) ile temel modelden farkın rastgele olup olmadığı gösterilmelidir. Bu, bilgisayar mühendisliği tezlerinde giderek daha sık aranan bir titizlik ölçütüdür ve tek bir çalıştırmadan elde edilen sayının “daha iyi” diye sunulmasını önler.
Yöntem bölümü hangi sırayla yazılmalı?
Önerilen sıra şöyledir: (1) problem tanımı ve formülasyonu, (2) veri kümesi, (3) önerilen yöntem/model mimarisi, (4) deney düzeni, (5) değerlendirme metrikleri. Bu sıra, okuyucunun önce neyin çözüldüğünü, sonra hangi veriyle, hangi modelle ve nasıl ölçüldüğünü adım adım takip etmesini sağlar. Model mimarisi anlatılırken bir mimari şeması (katman sayısı, boyutlar, aktivasyon fonksiyonları) eklemek, metin içi açıklamayı önemli ölçüde kısaltır.
Yöntem bölümünde en sık yapılan beş hata nedir?
- Hiperparametrelerin eksik raporlanması — sadece “model eğitildi” denip öğrenme oranı, epoch sayısı verilmemesi. Çözüm: bir hiperparametre tablosu ekleyin.
- Tek çalıştırmadan sonuç çıkarmak — rastgelelik etkisini göz ardı eden tek seferlik sayılar. Çözüm: en az 3-5 tekrar ve standart sapma raporlayın.
- Temel model seçilmemesi — önerilen yöntemin hiçbir bilinen yöntemle karşılaştırılmaması. Çözüm: alanın yerleşik en az bir temel modelini dahil edin.
- Veri sızıntısı (data leakage) — test verisinin ön işleme veya hiperparametre seçiminde kullanılması. Çözüm: tüm ön işleme adımlarını yalnızca eğitim kümesi üzerinde fit edin.
- Metrik gerekçelendirilmeden seçilmesi — dengesiz veri kümesinde sadece doğruluk raporlanması. Çözüm: veri dağılımını belirtip metriği buna göre seçin.
Nitel bir bilgisayar mühendisliği tezinde (ör. kullanılabilirlik çalışması) yöntem nasıl farklılaşır?
İnsan-bilgisayar etkileşimi gibi alt alanlarda yöntem bölümü, katılımcı sayısı, görev senaryoları, kullanılan kullanılabilirlik ölçeği (ör. System Usability Scale — SUS) ve veri toplama ortamı (laboratuvar veya uzaktan) gibi unsurları içerir. Burada “veri kümesi” yerine “katılımcı örneklemi”, “deney düzeni” yerine “görev senaryosu ve prosedür” ifadeleri kullanılır, ancak tekrarlanabilirlik ve ölçülebilirlik beklentisi aynı kalır.
Kod ve veri paylaşımı yöntem bölümünde belirtilmeli mi?
Giderek yaygınlaşan bir beklenti, kullanılan kodun ve (mümkünse) veri kümesinin bir depoda (ör. GitHub) paylaşılmasıdır. Yöntem bölümünün sonunda tek bir cümleyle bu belirtilebilir: “Deneylerde kullanılan kod ve model ağırlıkları [depo bağlantısı] üzerinden erişime açıktır.” Bu, hem tekrarlanabilirliği güçlendirir hem de jüri önünde ek bir güven unsuru oluşturur.
Yöntem bölümü savunma öncesi nasıl kontrol edilir?
Savunmaya girmeden önce şu sekiz maddeyi kontrol etmek faydalıdır:
- Veri kümesinin adı, boyutu ve bölünmesi açıkça belirtildi mi?
- Etiketleme veya toplama süreci (özgün veri kümesiyse) anlatıldı mı?
- Hiperparametreler tablo halinde raporlandı mı?
- Doğrulama ve test kümeleri ayrı tutuldu mu?
- En az bir temel model karşılaştırmaya dahil edildi mi?
- Sonuçlar tek çalıştırma yerine ortalama ± standart sapma ile verildi mi?
- Metrik seçimi veri dağılımına göre gerekçelendirildi mi?
- Donanım ve yazılım ortamı (GPU, çerçeve, sürüm) belirtildi mi?
Bir yapay zekâ aracı yöntem bölümünü yazarken nasıl kullanılır?
Tesify, veri kümesi, deney düzeni ve metrik seçimi arasındaki tutarlılığı kontrol eden bir taslak iskeleti üretir; hiperparametre tablosunun ve ablasyon çalışmasının eksik kalıp kalmadığını hatırlatır. Genel yöntem bölümü yazım kurallarıyla birlikte kullanıldığında, mühendislik tezine özgü teknik ayrıntıların atlanmamasına yardımcı olur. Modelin ve deneyin bilimsel doğruluğu her zaman öğrenciye ve danışmana aittir; araç yalnızca yapısal eksiksizliği destekler.
Tesify ile yöntem bölümünüzü şimdi taslaklayın.
Sık Sorulan Sorular
Veri kümesi bölümü kaç paragraf olmalı?
Genellikle 1-2 paragraf yeterlidir; kümenin adı, boyutu, bölünmesi ve varsa sınırlılıkları bu paragraflarda yer almalıdır.
Kaç kez deney tekrarlanmalı?
Sabit bir kural yoktur, ancak rastgelelik içeren modellerde en az 3-5 tekrar ve ortalama ± standart sapma raporlamak yaygın bir beklentidir.
Temel model (baseline) seçmek zorunlu mu?
Fiilen zorunludur; karşılaştırma yapılacak en az bir bilinen yöntem olmadan önerilen yöntemin katkısı değerlendirilemez.
Hangi durumda doğruluk yerine F1-skoru kullanılmalı?
Sınıflar dengesiz dağılmışsa (ör. bir sınıf verinin %5’inden azını oluşturuyorsa) doğruluk yanıltıcı olabilir; bu durumda F1-skoru veya precision/recall tercih edilir.
İstatistiksel anlamlılık testi her tezde zorunlu mu?
Zorunlu değildir, ancak birden fazla yöntemin karşılaştırıldığı tezlerde bu, sonuçların rastgele olmadığını göstermek için güçlü bir ek kanıttır.
Ablasyon çalışması ne zaman gereklidir?
Özellikle önerilen yöntem birden fazla yeni bileşen içeriyorsa, her bileşenin katkısını ayrı ayrı göstermek için ablasyon çalışması beklenir.
Veri sızıntısı nasıl önlenir?
Tüm ön işleme adımları (normalizasyon, özellik seçimi) yalnızca eğitim kümesi üzerinde öğrenilmeli, test kümesine bu öğrenilen parametrelerle uygulanmalıdır.
Kod paylaşımı zorunlu mu?
Çoğu üniversitede zorunlu değildir, ancak giderek yaygınlaşan bir iyi uygulama olarak jüri tarafından olumlu karşılanır.
Donanım bilgisi neden önemli?
Eğitim süresi ve bazı sonuçlar donanıma bağlı olarak değişebilir; GPU/CPU modeli belirtmek tekrarlanabilirliği ve sonuçların bağlamını netleştirir.
Yöntem bölümü kaç sayfa olmalı?
Sabit bir kural yoktur, ancak veri kümesi, deney düzeni ve metrik açıklamalarının tamamı genellikle 4-8 sayfa arasında yer bulur.
Doğrulama kümesi ile test kümesi neden karıştırılmamalı?
Hiperparametre seçimi test kümesi üzerinde yapılırsa raporlanan başarı oranı yapay olarak yükselir; bu yüzden doğrulama ve test kümeleri ayrı tutulmalı, test kümesi yalnızca son değerlendirmede kullanılmalıdır.
Etiketleyiciler arası uyum nasıl raporlanır?
Genellikle Cohen kappa veya Krippendorff alfa gibi bir katsayı ile raporlanır; düşük bir değer, etiketleme protokolünün gözden geçirilmesini gerektirir.
Ablasyon tablosunda kaç varyasyon olmalı?
Genellikle önerilen yöntemin her bileşeni için bir satır olacak şekilde 3-6 varyasyon yaygındır; her satır, tek bir bileşenin çıkarılmasıyla elde edilen sonucu gösterir.
Model mimarisi şeması zorunlu mu?
Zorunlu değildir, ancak katman sayısı ve boyutları çoksa bir şema, metin içi açıklamayı önemli ölçüde kısaltır ve jürinin mimariyi hızlı kavramasını sağlar.
Sonuç tablosunda ortalama ve standart sapma nasıl gösterilir?
Genellikle “ortalama ± standart sapma” biçiminde (ör. “%96,7 ± 0,3”) tek bir hücrede verilir; bu, tek bir çalıştırmadan elde edilen sayının yanıltıcı biçimde kesin gösterilmesini önler.